7.1 点估计:矩估计 + MLE + 评价 ⭐⭐⭐

一、矩估计法

⭐ 基本思想

用样本 kk 阶矩 Mk=1n∑XikM_k = \dfrac{1}{n}\sum X_i^k 估计总体 kk 阶矩 μk=E(Xk)\mu_k = E(X^k)(由大数定律,Mk→PμkM_k\xrightarrow{P}\mu_k)。

三步法:

  1. 用 θ1,…,θm\theta_1, \ldots, \theta_m 表达 μ1,…,μm\mu_1, \ldots, \mu_m(前 mm 阶总体矩)
  2. 令 μk=Mk\mu_k = M_k(k=1,…,mk = 1, \ldots, m),得方程组
  3. 反解出 θ^j\hat\theta_j

七大分布矩估计速查

分布关系式θ^\hat\theta
B(1,p)B(1, p)E(X)=pE(X) = pp^=Xˉ\hat p = \bar X
B(m,p)B(m, p) (mm 知)E(X)=mpE(X) = mpp^=Xˉ/m\hat p = \bar X/m
P(λ)P(\lambda)E(X)=λE(X) = \lambdaλ^=Xˉ\hat\lambda = \bar X
G(p)G(p)E(X)=1/pE(X) = 1/pp^=1/Xˉ\hat p = 1/\bar X
U(a,b)U(a, b)E=(a+b)/2, D=(b−a)2/12E = (a+b)/2,\,D = (b-a)^2/12a^=Xˉ−3Sn2, b^=Xˉ+3Sn2\hat a = \bar X-\sqrt{3 S_n^2},\,\hat b = \bar X+\sqrt{3 S_n^2}
E(λ)E(\lambda)E(X)=1/λE(X) = 1/\lambdaλ^=1/Xˉ\hat\lambda = 1/\bar X
N(μ,σ2)N(\mu, \sigma^2)E=μ, D=σ2E = \mu,\,D = \sigma^2μ^=Xˉ, σ^2=Sn2\hat\mu = \bar X,\,\hat\sigma^2 = S_n^2

Sn2=1n∑(Xi−Xˉ)2S_n^2 = \dfrac{1}{n}\sum(X_i-\bar X)^2(注意是 nn,不是 n−1n-1)。

例 1(双参数矩估计):X∼N(μ,σ2)X\sim N(\mu, \sigma^2),求 μ,σ2\mu, \sigma^2 矩估计。
解

μ1=μ=Xˉ⇒μ^=Xˉ\mu_1 = \mu = \bar X\Rightarrow\hat\mu = \bar X。

μ2−μ12=σ2=M2−Xˉ2=1n∑Xi2−Xˉ2=1n∑(Xi−Xˉ)2=Sn2\mu_2 - \mu_1^2 = \sigma^2 = M_2 - \bar X^2 = \dfrac{1}{n}\sum X_i^2 - \bar X^2 = \dfrac{1}{n}\sum(X_i-\bar X)^2 = S_n^2。

所以 σ^2=Sn2\hat\sigma^2 = S_n^2(用 nn,不是 n−1n-1)。

二、最大似然估计(MLE)

⭐ 基本思想

"找使观察样本概率最大的参数值"。

四步法:

  1. 写似然函数 L(θ)=∏i=1nf(Xi;θ)L(\theta) = \prod_{i=1}^n f(X_i; \theta)(连续)或 ∏P(Xi;θ)\prod P(X_i; \theta)(离散)
  2. 取对数 ℓ(θ)=ln⁡L=∑ln⁡f(Xi;θ)\ell(\theta) = \ln L = \sum\ln f(X_i; \theta)
  3. 求导置零 dℓdθ=0\dfrac{\dd\ell}{\dd\theta} = 0,解得 θ^\hat\theta
  4. 验证极大(二阶导 < 0,或看单调性)

七大分布 MLE 速查

分布ln⁡L\ln L 关键项θ^MLE\hat\theta_{\text{MLE}}
B(1,p)B(1, p)∑Xiln⁡p+(n−∑Xi)ln⁡(1−p)\sum X_i\ln p+(n-\sum X_i)\ln(1-p)p^=Xˉ\hat p = \bar X
P(λ)P(\lambda)∑Xiln⁡λ−nλ\sum X_i\ln\lambda-n\lambdaλ^=Xˉ\hat\lambda = \bar X
G(p)G(p)(n−∑Xi)ln⁡(1−p)+nln⁡p(n-\sum X_i)\ln(1-p)+n\ln pp^=1/Xˉ\hat p = 1/\bar X
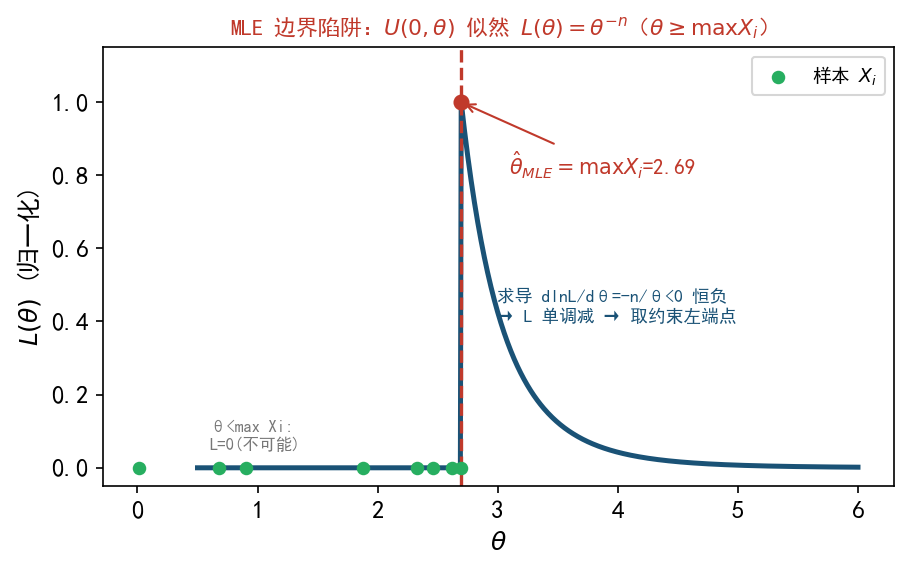
U(0,θ)U(0, \theta)−nln⁡θ-n\ln\theta(关于 θ\theta 单调减)θ^=max⁡Xi\hat\theta = \max X_i(边界!)
E(λ)E(\lambda)nln⁡λ−λ∑Xin\ln\lambda-\lambda\sum X_iλ^=1/Xˉ\hat\lambda = 1/\bar X
N(μ,σ2)N(\mu, \sigma^2)−n2ln⁡(2πσ2)−12σ2∑(Xi−μ)2-\frac{n}{2}\ln(2\pi\sigma^2)-\frac{1}{2\sigma^2}\sum(X_i-\mu)^2μ^=Xˉ, σ^2=Sn2\hat\mu = \bar X,\,\hat\sigma^2 = S_n^2
⭐ MLE 不变性原理(满分笔记重点)

若 θ^\hat\theta 是 θ\theta 的 MLE,g(θ)g(\theta) 是 θ\theta 的(单值)函数,则 g(θ^)g(\hat\theta) 是 g(θ)g(\theta) 的 MLE。

用途:问 σ,ln⁡λ,ep\sqrt\sigma, \ln\lambda, e^p 等的 MLE,直接代 θ^MLE\hat\theta_{\text{MLE}} 即可。

题 ★★★ 20-21-2 第 18 题(带平移指数 MLE):XX 密度 f(x;α,β)=βe−β(x−α), x≥αf(x; \alpha, \beta) = \beta e^{-\beta(x-\alpha)},\,x\geq\alpha。求 α,β\alpha, \beta 的 MLE。
解

似然 L(α,β)=βne−β∑(Xi−α)1α≤min⁡XiL(\alpha, \beta) = \beta^n e^{-\beta\sum(X_i-\alpha)}\mathbf 1_{\alpha\leq\min X_i}。

对 α\alpha:βnα\beta n\alpha 是单调增(β>0\beta>0),但约束 α≤min⁡Xi\alpha\leq\min X_i,故 α^MLE=min⁡Xi\hat\alpha_{\text{MLE}} = \min X_i(边界 MLE!求导失效)。

对 β\beta:固定 α=α^\alpha = \hat\alpha,ln⁡L=nln⁡β−β∑(Xi−α^)=nln⁡β−βn(Xˉ−α^)\ln L = n\ln\beta-\beta\sum(X_i-\hat\alpha) = n\ln\beta-\beta n(\bar X-\hat\alpha)。

∂βℓ=nβ−n(Xˉ−α^)=0⇒β^MLE=1Xˉ−min⁡Xi\partial_\beta\ell = \dfrac{n}{\beta}-n(\bar X-\hat\alpha) = 0\Rightarrow\hat\beta_{\text{MLE}} = \dfrac{1}{\bar X-\min X_i}。

边界 MLE 识别:定义域含 θ\theta(如 X≤θX\leq\theta 或 X≥θX\geq\theta),似然函数关于 θ\theta 单调 → 不要求导,看单调性!这是 MLE 题最常见的陷阱。
U(0,theta) 似然函数边界型 MLE
边界型 MLE 的几何真相(以 U(0,θ)U(0,\theta) 为例):似然 L(θ)=θ−nL(\theta)=\theta^{-n} 只在 θ≥max⁡Xi\theta\geq\max X_i 时非零,且对 θ\theta 单调递减(求导 dln⁡Ldθ=−nθ<0\frac{\dd\ln L}{\dd\theta}=-\frac{n}{\theta}<0 恒负,永远取不到 00)。所以最大值落在约束的左端点 θ^MLE=max⁡Xi\hat\theta_{\text{MLE}}=\max X_i,绝不能令导数为零。
⚠️ 你在这反复卡(5/29 连问"MLE 没掌握"):见到 f(x;α,β)=βe−β(x−α) (x≥α)f(x;\alpha,\beta)=\beta e^{-\beta(x-\alpha)}\,(x\geq\alpha)、f=2θ2x−3 (x>θ)f=2\theta^2x^{-3}\,(x>\theta)、U(0,θ)U(0,\theta) 这类定义域里出现参数的题,第一反应不是求导,而是先盯死约束方向: 破法:把"求导=0"换成"画 L(θ)L(\theta) 单调性 + 看约束端点"。双参数(如平移指数 α,β\alpha,\beta)先用边界法定 α^=X(1)\hat\alpha=X_{(1)},再把 α^\hat\alpha 代回对 β\beta 正常求导。这正是 5/29 那道一题打通全链的题。

三、估计量评价 ⭐⭐⭐

⭐ 三大评价标准
  1. 无偏性:E(θ^)=θE(\hat\theta) = \theta(对所有 θ\theta 成立)
  2. 有效性:两个无偏估计比较,方差小者更有效
  3. 一致性 / 相合性:θ^n→Pθ\hat\theta_n\xrightarrow{P}\theta(n→∞n\to\infty)
必背无偏性结论
⭐ 必背关键公式(连考 3 套!)
E(Xˉ2)=D(Xˉ)+(EXˉ)2=σ2n+μ2E(\bar X^2) = D(\bar X)+(E\bar X)^2 = \dfrac{\sigma^2}{n}+\mu^2

这个公式在 23-24-2、23-24-1、22-23-2 连续 3 套真题中反复使用。题型:"Xˉ2\bar X^2 是不是 μ2\mu^2 的无偏估计?"

题 ★★★★★ 23-24-2 第 17 题("差到好"排序,连续 3 套都考!):X∼N(0,σ2)X\sim N(0, \sigma^2) 简单样本 X1,…,XnX_1, \ldots, X_n。判断三个统计量是否为 σ2\sigma^2 的无偏估计,不是请矫正,再对矫正后估计量"差到好"排序: S12=1n∑Xi2,S22=1n∑(Xi−Xˉ)2,S32=Xˉ2S_1^2 = \dfrac{1}{n}\sum X_i^2,\quad S_2^2 = \dfrac{1}{n}\sum(X_i-\bar X)^2,\quad S_3^2 = \bar X^2
解(满分模板)

(a) 无偏性判断(μ=0\mu = 0):

  • E(S12)=1n∑E(Xi2)=1n⋅nσ2=σ2E(S_1^2) = \dfrac{1}{n}\sum E(X_i^2) = \dfrac{1}{n}\cdot n\sigma^2 = \sigma^2 → 无偏
  • E(S22)=n−1nσ2E(S_2^2) = \dfrac{n-1}{n}\sigma^2 → 有偏
  • E(S32)=E(Xˉ2)=D(Xˉ)+(EXˉ)2=σ2/n+0=σ2/nE(S_3^2) = E(\bar X^2) = D(\bar X)+(E\bar X)^2 = \sigma^2/n+0 = \sigma^2/n → 有偏

(b) 矫正:

  • S^22=nn−1S22\hat S_2^2 = \dfrac{n}{n-1}S_2^2(即标准 S2S^2)
  • S^32=nXˉ2\hat S_3^2 = n\bar X^2

(c) 方差比较(用 Xi∼N(0,σ2)⇒Xi2/σ2∼χ2(1)X_i\sim N(0, \sigma^2)\Rightarrow X_i^2/\sigma^2\sim\chi^2(1),E(Xi2)=σ2, D(Xi2)=2σ4E(X_i^2) = \sigma^2,\,D(X_i^2) = 2\sigma^4):

  • D(S12)=1n2∑D(Xi2)=1n2⋅n⋅2σ4=2σ4nD(S_1^2) = \dfrac{1}{n^2}\sum D(X_i^2) = \dfrac{1}{n^2}\cdot n\cdot 2\sigma^4 = \dfrac{2\sigma^4}{n}
  • S^22=nn−1S22=1n−1∑(Xi−Xˉ)2=S2\hat S_2^2 = \dfrac{n}{n-1}S_2^2 = \dfrac{1}{n-1}\sum(X_i-\bar X)^2 = S^2(标准样本方差)。由 (n−1)S2σ2∼χ2(n−1)\dfrac{(n-1)S^2}{\sigma^2}\sim\chi^2(n-1) 得 D(S2)=σ4(n−1)2⋅2(n−1)=2σ4n−1D(S^2) = \dfrac{\sigma^4}{(n-1)^2}\cdot 2(n-1) = \dfrac{2\sigma^4}{n-1}。故 D(S^22)=2σ4n−1D(\hat S_2^2) = \dfrac{2\sigma^4}{n-1}
  • Xˉ∼N(0,σ2/n)⇒nXˉ2/σ2∼χ2(1)\bar X\sim N(0, \sigma^2/n)\Rightarrow n\bar X^2/\sigma^2\sim\chi^2(1),故 D(nXˉ2)=σ4⋅2=2σ4D(n\bar X^2) = \sigma^4\cdot 2 = 2\sigma^4

排序(小 → 大 即 好 → 差):

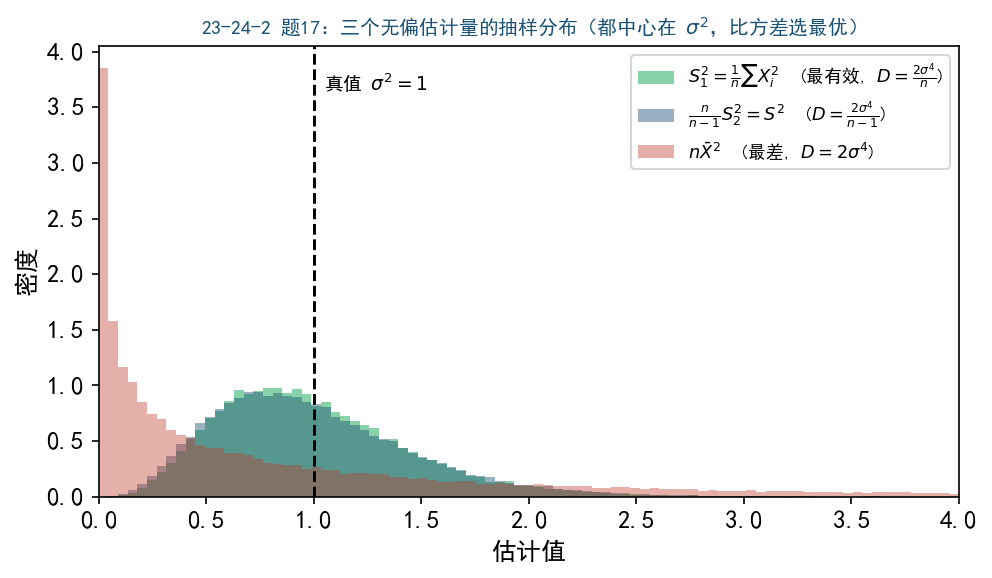
D(S12)=2σ4n<D(S^22)=2σ4n−1<D(S^32)=2σ4D(S_1^2) = \dfrac{2\sigma^4}{n} < D(\hat S_2^2) = \dfrac{2\sigma^4}{n-1} < D(\hat S_3^2) = 2\sigma^4

即 S12S_1^2 最有效,S^32=nXˉ2\hat S_3^2 = n\bar X^2 最差。

本题考点全集:① 用 E(Xˉ2)=σ2/n+μ2E(\bar X^2) = \sigma^2/n+\mu^2 公式判无偏 ② 用 χ2\chi^2 算方差 ③ 比较选最优。

三个无偏估计量的抽样分布与方差比较
把三个估计量矫正成无偏后各跑 44 万次抽样(n=10, σ2=1n=10,\ \sigma^2=1):三条直方图都中心在 σ2=1\sigma^2=1(无偏),但胖瘦不同——S12=1n∑Xi2S_1^2=\frac1n\sum X_i^2(绿,最窄=方差最小=最有效)< nn−1S22=S2<\ \frac{n}{n-1}S_2^2=S^2(蓝)< nXˉ2<\ n\bar X^2(红,最胖=最差)。"有效性排序"比的就是这个胖瘦,对应方差 2σ4n<2σ4n−1<2σ4\frac{2\sigma^4}{n}<\frac{2\sigma^4}{n-1}<2\sigma^4。

四、Rao-Cramer 不等式(满分笔记重点)

θ^\hat\theta 是 θ\theta 的无偏估计,则

D(θ^)≥1nE ⁣[(∂ln⁡f(X;θ)∂θ)2]D(\hat\theta)\geq\dfrac{1}{nE\!\left[\left(\dfrac{\partial\ln f(X;\theta)}{\partial\theta}\right)^2\right]}

右边称为 Rao-Cramer 下界(信息不等式)。达到下界的 θ^\hat\theta 是 有效估计量。

常见有效估计量(直接背!)

五、矩估计 vs MLE 对比

方法思想优势劣势
矩估计样本矩 = 总体矩计算简单;无需知道分布族细节可能有偏;未必最优;不唯一
MLE使样本概率最大大样本下渐近无偏、渐近有效(CR 下界)边界 MLE 求导失效;计算较复杂

结论:实际应用中 MLE 更常用,但教学上两者都要会。

六、易错点清单

记忆口诀:

七、真题套路 · 二级结论 · 速算技巧

矩估计套路(3 步法)

  1. 列出总体的 kk 阶矩(用 θ\theta 表达)
  2. 设方程 E(Xk)=Mk=1n∑XikE(X^k) = M_k = \dfrac{1}{n}\sum X_i^k(双参数用 μ1,μ2\mu_1, \mu_2)
  3. 反解 θ^\hat\theta

MLE 套路(4 步法)

  1. 写似然 L(θ)=∏f(xi;θ)L(\theta) = \prod f(x_i; \theta)
  2. 取对数 ℓ(θ)=∑ln⁡f(xi;θ)\ell(\theta) = \sum\ln f(x_i; \theta)
  3. 求导 dℓdθ=0\dfrac{\dd\ell}{\dd\theta} = 0 解 θ^\hat\theta
  4. 验极大(二阶导 <0<0;定义域含 θ\theta → 看单调性)

必背二级结论

  1. E(Xˉ2)=σ2/n+μ2E(\bar X^2) = \sigma^2/n+\mu^2(连考 3 套,必背!)
  2. Xˉ\bar X 是 μ\mu 的无偏估计(任意分布)
  3. S2=1n−1∑(Xi−Xˉ)2S^2 = \frac{1}{n-1}\sum(X_i-\bar X)^2 是 σ2\sigma^2 的无偏估计(任意分布)
  4. Sn2=1n∑(Xi−Xˉ)2S_n^2 = \frac{1}{n}\sum(X_i-\bar X)^2 有偏:E(Sn2)=n−1nσ2E(S_n^2) = \frac{n-1}{n}\sigma^2
  5. 样本标准差 SS 不是 σ\sigma 的无偏(Jensen)
  6. MLE 不变性:g(θ^)MLE=g(θ^MLE)g(\hat\theta)_{\text{MLE}} = g(\hat\theta_{\text{MLE}})
  7. 正态 MLE 与矩估计同:μ^=Xˉ, σ^2=Sn2\hat\mu = \bar X,\,\hat\sigma^2 = S_n^2
  8. 有效估计量(常见):B(1,p)B(1,p) 的 p^=Xˉ\hat p = \bar X;P(λ)P(\lambda) 的 λ^=Xˉ\hat\lambda = \bar X;N(μ,σ2)N(\mu,\sigma^2) 的 μ^=Xˉ\hat\mu = \bar X;E(λ)E(\lambda) 的 Xˉ\bar X 是 1/λ1/\lambda 的有效估计
  9. Rao-Cramer 下界:D(θ^)≥1nE[(∂ln⁡f/∂θ)2]D(\hat\theta)\geq\dfrac{1}{nE[(\partial\ln f/\partial\theta)^2]}
  10. 边界 MLE:U(0,θ)U(0,\theta) 的 θ^=max⁡Xi\hat\theta = \max X_i;f(x)=βe−β(x−α)f(x) = \beta e^{-\beta(x-\alpha)} 的 α^=min⁡Xi\hat\alpha = \min X_i
  11. χ2(1)\chi^2(1) 方差:D(χ2(1))=2D(\chi^2(1)) = 2 → 推出 D(X2)=2σ4D(X^2) = 2\sigma^4 当 X∼N(0,σ2)X\sim N(0,\sigma^2)
  12. 相合估计判别:无偏 + D(θ^n)→0D(\hat\theta_n)\to 0 时相合(用 Chebyshev)

速算与解题技巧

  1. 看到 X∼X\sim 单参数分布且 E(X)=g(θ)E(X) = g(\theta),直接 θ^=g−1(Xˉ)\hat\theta = g^{-1}(\bar X)
  2. MLE 求 ln⁡L\ln L 时先化简:把指数函数、阶乘等无关项分离
  3. 定义域含 θ\theta(x≥θx\geq\theta 或 x≤θx\leq\theta)立刻警惕边界 MLE
  4. 判无偏:E(θ^)=θE(\hat\theta) = \theta(不是某一个 θ\theta,是所有)
  5. 矫正系数:若 E(T)=cθE(T) = c\theta,则矫正后 θ^=T/c\hat\theta = T/c
  6. 比较方差时用 χ2\chi^2:X∼N(0,σ2)⇒X2=σ2χ2(1), D(X2)=2σ4X\sim N(0,\sigma^2)\Rightarrow X^2 = \sigma^2\chi^2(1),\,D(X^2) = 2\sigma^4
  7. D(Xˉ2)D(\bar X^2) 计算:Xˉ∼N(μ,σ2/n)\bar X\sim N(\mu,\sigma^2/n),再算 D(Xˉ2)=2(σ2/n)2+4μ2(σ2/n)D(\bar X^2) = 2(\sigma^2/n)^2+4\mu^2(\sigma^2/n)(一般公式)
  8. 有效性"差到好"排序:先矫正成无偏,再算方差排序

常错"小坑"清单